2025年发表于 Nature Communications 的研究提出一种新的未来引导学习框架(Future-Guided Learning, FGL),核心思想并不是简单增加模型规模,而是让一个能够“看到相对未来”的教师模型,在训练阶段不断纠正负责长时程预测的学生模型。这一设计受到大脑预测编码理论(predictive coding)的启发:大脑并非只是被动接收信息,而是不断形成对未来输入的预测,并利用预测与真实输入之间的误差更新内部模型。研究团队把这种“预测—比较—纠错”的机制重新写入时间序列深度学习框架,并在脑电癫痫预测和混沌动力系统预测两类截然不同的任务中进行了验证。
关键词:时间序列预测(time-series forecasting)、未来引导学习(Future-Guided Learning, FGL)、预测编码(predictive coding)、知识蒸馏(knowledge distillation)、癫痫预测(seizure prediction)、脑电图(EEG)、长期预测(long-horizon forecasting)
论文题目:A predictive approach to enhance time-series forecasting论文链接:https://doi.org/10.1038/s41467-025-63786-4论文来源:Nature Communications
近年来,Transformer、RNN 以及各种深度时序模型不断被用于时间序列预测。然而,与图像分类不同,时间序列模型面对的并不是一个相对固定的输入分布。真实世界中的信号往往同时具有随机性、噪声、非平稳性(non-stationarity)以及外部扰动,一个在当前时刻表现良好的模型,并不意味着它能够可靠地预测更远的未来。随着预测时间范围不断延长,模型必须逐渐依赖那些跨越较长时间尺度的结构信息,而不是眼前几个时间点的局部模式。一旦数据生成过程发生变化,或者某个突发事件打破原有规律,预测误差便可能迅速累积,这也是为什么即使先进的深度学习模型,在长时程预测中仍然面临明显困难。过去已经存在一些处理分布漂移(distribution drift)的方法。例如Page-Hinkley检验和漂移检测方法(Drift Detection Method, DDM)会持续监控模型误差,当误差统计发生显著改变时发出警报,然后重新训练模型,或者利用最近的数据进行微调。但是这类方法本质上更接近“发现模型坏了以后再修”。重新训练可能导致长期知识丢失,而且高度依赖人为设定的漂移阈值。另一类自监督学习方法虽然也使用“预测未来”作为训练任务,例如预测后续视频帧或者音频表示,但预训练和真正的在线预测通常彼此分离,因此模型并不会利用每一个新观察到的结果持续修正自己的未来预测。Future-Guided Learning:让“未来的老师”指导“过去的学生”
本研究提出的 Future-Guided Learning(FGL)最巧妙的地方,在于它重新解释了知识蒸馏(Knowledge Distillation, KD)。传统知识蒸馏通常包含一个性能更强的教师模型和一个相对较小的学生模型。教师与学生面对的是同一个输入、同一个预测目标,只不过学生不仅学习真实标签,同时也学习教师输出的概率分布。FGL则在教师和学生之间加入了一个关键变量:时间差(temporal offset)。在FGL中,教师模型位于学生模型的“相对未来”。教师需要完成的是更近距离、通常也更容易的预测任务;学生模型则需要完成更远距离、更困难的预测。训练学生时,不仅要求它对最终真实结果预测正确,还要求它的概率分布尽量接近那个已经获得更多未来信息的教师模型。下图非常直观地展示了这一关系:学生站在时间轴较早的位置,需要预测远处发生的事情;教师则站在相对靠后的时间点,因此距离目标更近。训练阶段,教师产生的概率分布通过KL散度(Kullback–Leibler divergence, KL divergence)传递给学生,从而使学生获得一种“来自未来的软监督”。换句话说,FGL并不是把未来数据直接泄露给测试阶段的模型。未来信息只存在于训练阶段的监督机制中。真正预测时,学生仍然只能使用当前和过去的信息。图 1. FGL 及其应用概述。A. 在 FGL 框架中,教师模型作用于学生模型相对未来的时间点,并专注于长期预测。在针对未来导向任务完成教师模型训练后,在学生模型训练阶段,两个模型同时进行推理。随后提取教师模型和学生模型输出的概率分布,并根据公式(1)计算相应的损失。A1. 知识蒸馏通过类别概率分布之间的 KL 散度实现信息传递。B. 在事件预测场景中,教师模型直接基于事件本身进行训练,而学生模型则被训练用于预测这些事件。通过知识蒸馏,将未来标签从教师模型传递给学生模型,使得学生模型即使只使用相对过去的数据,也能在预测上更加接近教师模型。C. 在回归预测场景中,教师模型和学生模型分别执行短期预测和长期预测。与事件预测类似,在训练过程中,学生模型从教师模型中获取信息,从而增强其对更远期未来进行预测的能力。这里还有一个容易被忽略、却非常重要的设计。教师模型告诉学生的并不是简单的“0还是1”,而是一整个预测概率分布。例如在癫痫预测中,教师可能并不是100%认为某段EEG对应即将发生的癫痫,而是给出“癫痫概率0.72、非癫痫概率0.28”这样的软信息。这种概率结构意味着教师同时传递了自己的不确定性(uncertainty)。因此,学生模型并非机械复制教师的答案,而是在学习:“当离真正事件更近时,一个模型对这个事件究竟有多确定?”研究者认为,这种不确定性的传递与预测编码理论具有直接联系。在预测编码框架中,大脑不断比较内部预测与真实感知输入,当二者出现差异时产生预测误差(prediction error),之后内部模型再根据这一误差进行调整。FGL实际上将类似的结构移植到了机器学习中。
研究首先把FGL应用于一个癫痫发作预测(seizure prediction)任务,使用了两个标准EEG数据集(CHBMIT和AES),并将FGL与Multi-Channel Vision Transformer(MViT)和CNN-LSTM两种模型进行比较。MViT和CNN-LSTM均属于时序生物医学数据中具有代表性的深度学习架构。其中,教师模型负责的是癫痫检测:它看到距离癫痫真正发生更近的数据,因此判断“现在是不是癫痫事件”相对容易。学生模型面对的任务则更加困难,它需要在癫痫尚未发生时,使用更早期的EEG片段预测未来是否会出现癫痫。这里,教师相当于在告诉学生:等真正靠近癫痫发作时,我会看到怎样的概率模式;你现在虽然离事件还很远,但可以提前学习这种模式。在CHBMIT实验中,研究者采取了患者特异性FGL(patient-specific FGL)的模式,首先针对每位患者分别预训练一个癫痫检测教师模型,训练50个epoch。值得注意的是,教师模型预训练时专门排除了癫痫发作前期片段,希望保留教师面对学生训练样本时的不确定性,而不是让教师过度熟悉这些发作前模式。之后,再训练对应的学生模型25个epoch。每一个训练样本都会同时输入教师和学生模型,获得各自的类别概率,然后利用真实标签与教师—学生概率分布之间的差异共同更新学生模型。结果非常突出。在CHBMIT数据集上,与基线模型相比,FGL使平均AUC-ROC提高了 44.8%。大多数患者的预测性能都有改善,其中第5号患者的提升达到基线的 3.84倍。只有第23号患者相对于CNN-LSTM出现下降,但其结果仍明显优于MViT。下图显示,FGL不仅提高了平均性能,其结果的误差范围也整体更加稳定。图 2. 癫痫发作预测结果。(A) CHBMIT, (B) AES,和(C)数据集平均值。测试了三种方法:MViT、CNN-LSTM和FGL。
真实临床场景中,一个明显的问题是:我们未必拥有每个患者足够多的癫痫发作数据来训练一个专属教师。因此,研究进一步设计了一个更困难的场景——患者非特异性FGL(patient non-specific FGL)。其中 AES 数据集本身只有发作前期样本,却缺少与之对应的完整标记癫痫发作数据。因此研究没有利用同一批个体训练教师,而是引入另一个独立的UPenn and Mayo Clinic Seizure Detection数据集。AES 包括5只犬和2名人类受试者,而UPenn-Mayo数据包括4只犬和8名人类患者。研究者因此分别训练了一个犬类“通用教师”(universal teacher)和一个人类“通用教师”。教师在不同个体的发作间期数据(interictal data)与随机抽取的癫痫发作数据上训练,从而学习跨个体更加普遍的癫痫模式。由于不同数据集之间EEG通道数量和数据格式并不完全一致,研究者进一步根据不同通道对癫痫检测的贡献,选择最重要的top-k EEG通道,再根据学生模型需要调整通道数量,以实现教师—学生之间的知识迁移。即使教师和学生来自不同个体、甚至不同数据来源,FGL在AES上仍然较CNN-LSTM平均提升 8.9%。这一提升虽然低于患者特异性实验中的44.8%,却在测试受试者中表现得更加一致。这一结果也引出了文章讨论中的一个重要权衡:患者特异性教师可以捕捉个体化癫痫特征,因此性能提升更大;而通用教师利用更加多样、异质的大样本,提升幅度相对有限,却具有更好的跨个体稳定性。因此,未来可以先利用通用教师获得稳定基础模型,在患者数据足够时,再进行个体化微调。
癫痫预测本质上属于分类问题,但真正的时间序列预测通常面对的是连续数值。于是研究的第二部分转向著名的Mackey–Glass混沌时间序列。为此,研究者首先把连续回归任务重新转化成一个概率分类问题,即把整个连续数值范围划分成B个宽度相等的区间,也就是“bins”。模型不再直接输出一个单独的预测数值,而是输出这个未来值落入各个区间的概率。因此,教师模型和学生模型就拥有了维度完全相同的概率分布,也就可以继续通过KL散度进行知识蒸馏。最后需要恢复连续预测值时,再根据各个bin中心位置及其概率得到实际预测。下图展示了从连续Mackey–Glass轨迹到离散概率分布,再从分布恢复预测轨迹的全过程。这种处理还有一个额外好处:连续预测中的“不确定性”因此变得可以显式表达,不再只是说“未来值等于10.2”,而是可以表达“未来值更可能落在这一段,但附近几个区间同样具有一定概率”。图 3. 离散化使 Mackey–Glass 任务上的知识蒸馏成为可能。a. 在生成混沌轨迹后,将每一个标量预测目标 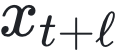 量化 到 C 个等宽区间(bins)中的某一个。因此,原本的回归问题被重新表述为一个 C 类分类问题,使教师模型和学生模型能够交换具有相同维度的 soft logits;这是 FGL 中使用 KL 散度进行知识蒸馏的必要条件。b.教师模型进行下一步预测。c.基线模型在没有未来信息指导的情况下进行 5 步预测。d.经过 FGL 训练的学生模型预测相同的时间跨度。通过将学生模型的 logit 分布与教师模型针对近未来预测得到的 logits 对齐,FGL 学生模型能够在离散区间空间中捕获邻域信息,从而获得明显更低的均方误差,并得到更加平滑的重建结果。在Mackey–Glass实验中,教师负责下一时间步预测,而学生负责更长时间范围的预测。因此,教师始终面对一个相对容易的问题。假设学生需要预测较远的未来值,教师则能够站在离目标更近的位置完成短时程预测。教师的软概率分布随后作为学生训练的额外监督。研究测试了25个bins和50个bins两种情况。bins越多,每个区间越窄,理论上的数值分辨率也越高,但分类难度随之增加。结果显示,在25 bins条件下,基线模型平均MSE为4.09,而FGL模型分别降低到3.64和3.56,对应约 11%—13%的误差下降。当区间增加到50 bins、任务明显变难以后,基线MSE上升至28.34,而两种FGL配置分别只有11.95和11.68,误差下降超过一半。研究同时指出,结合教师蒸馏信号与真实标签的模型通常略优于仅依赖蒸馏标签的模型,说明“来自未来的信息”并不能完全替代ground truth,二者结合才更稳定。
进一步分析不同预测时间距离后,研究发现了一个很有意思的现象。随着预测时间不断拉长,传统模型的误差往往快速增加,甚至出现极端异常。例如在50 bins实验中,基线模型在某一个较远预测时间点的MSE高达 195.62。相比之下,两个FGL模型的误差均被控制在12以下。在25 bins条件下也可以看到类似趋势:基线模型的MSE会随着预测距离增加而明显升高,而FGL的误差曲线更加平缓。也就是说,FGL不仅降低平均预测误差,还让“预测距离越远,性能逐步退化”的过程变得更加可控。研究将这种现象解释为:短时程教师提供了一种动态的“上界”或参照,使学生不容易在长时程预测中走向灾难性误差。与此同时,由于蒸馏传递的是概率和不确定性,而非强制要求学生复制教师的某一个答案,即使教师本身出现一定误差,学生也不会因此受到过度惩罚。
这篇文章另一有意思的地方,在于研究试图从预测编码(predictive coding)的角度解释FGL。预测编码理论认为,大脑可以被理解为一个不断进行时间推断的系统。高级脑区持续形成对低级感觉输入的预测,而真实输入与预测之间的差异形成预测误差;这些误差随后向上传递,推动内部模型不断更新。下图进一步将这一思想扩展为层级FGL(hierarchical FGL)。研究设想,与其只有一个短时程教师和一个长时程学生,还可以在二者之间建立多个中间预测器。每一个中间模型既是前一个模型的学生,又是后一个模型的教师,从而逐层把不确定性向长时程预测模型传递。图 4. 预测编码与 FGL。A. 脑内预测编码机制示意图。信息首先由初级视觉皮层(V1)接收,随后传递至大脑中具有更高复杂抽象层级的不同区域。这种信息传递可以理解为一种预测估计:高层级脑区帮助预测低层级脑区的活动。预测结果与真实输出之间的差异即为预测误差。图中颜色较浅的区域代表较低层级的抽象表征,而颜色越深表示表征需求逐渐增加,例如思维、运动等更复杂的功能。B. 分层 FGL(hierarchical FGL)通过不确定性(uncertainty)来传播信息。FGL 用每一层的不确定性来替代预测编码中的预测估计量。这种不确定性通过相邻层概率分布之间的 KL 散度进行传递。每一层的预测结果与真实输出之间的差异构成预测误差。在这种类比中,初级视觉皮层(primary visual cortex, V1)类似于处理短时间尺度、低层感觉信息的中间预测器,而前额叶皮层(prefrontal cortex)则类似于位于更高层级、整合抽象模式并处理更长时间尺度信息的模型。这里并非想说明 FGL 就是人脑真实运行机制,而是指出二者具有相似的计算结构:不同时间尺度和不同层级之间不断传递预测与不确定性,而预测误差则负责推动系统更新。
综合两个任务,研究认为FGL能够发挥作用主要依赖两个原则。第一,是从距离未来更近、相对更有把握的教师模型中蒸馏不确定性,而不是仅仅传递一个确定标签。第二,是将这种未来蒸馏信号与真实标签共同用于训练,从而在提升长时程预测能力的同时维持模型稳定性。这也使得这项研究与单纯“换一个更大的Transformer”“增加更多训练数据”的路线有所不同。它改变的是监督信息在时间轴上的组织方式:模型不仅根据最终预测错了多少学习,还可以借助一个更接近未来目标的模型理解——随着目标逐渐靠近,我们究竟应该变得多确定?这项工作仍然处于方法验证阶段。癫痫实验集中于两个数据集,连续时间序列部分则采用合成的Mackey–Glass混沌系统。研究也明确提出,下一步希望探索患者特异性教师与通用教师的自适应组合、多预测时间尺度、多模态预测,并将FGL与Page-Hinkley等在线漂移适应方法结合,以进一步提高模型面对非平稳环境时的鲁棒性。
为系统梳理自指与AI领域的最新进展,北京师范大学系统科学学院教授、集智俱乐部创始人张江老师联合清华大学人工智能学院博士生李筱健共同发起「自指与AI:从大模型自我改进到意识研究」读书会,组织对该主题感兴趣的研究者与探索者共同研读前沿文献、交流研究思路。读书会将于2026年8月29日起每周六下午14:00-16:00线上开展,持续约10周,包含主讲分享与讨论交流,并提供会后视频回放,诚邀相关领域研究者及跨学科兴趣者参与。
6. 高考分数只是张入场券,你的科研冒险在这里启航!
7. 加入集智字幕组:成为复杂科学知识社区的“织网人”
#速递